2026-09-27 IA Escalabilidade Checklist
Sua IA vai aguentar o pico de fim de ano?
Setembro é quando quem cuida de sistemas de e-commerce começa a se preparar para novembro.
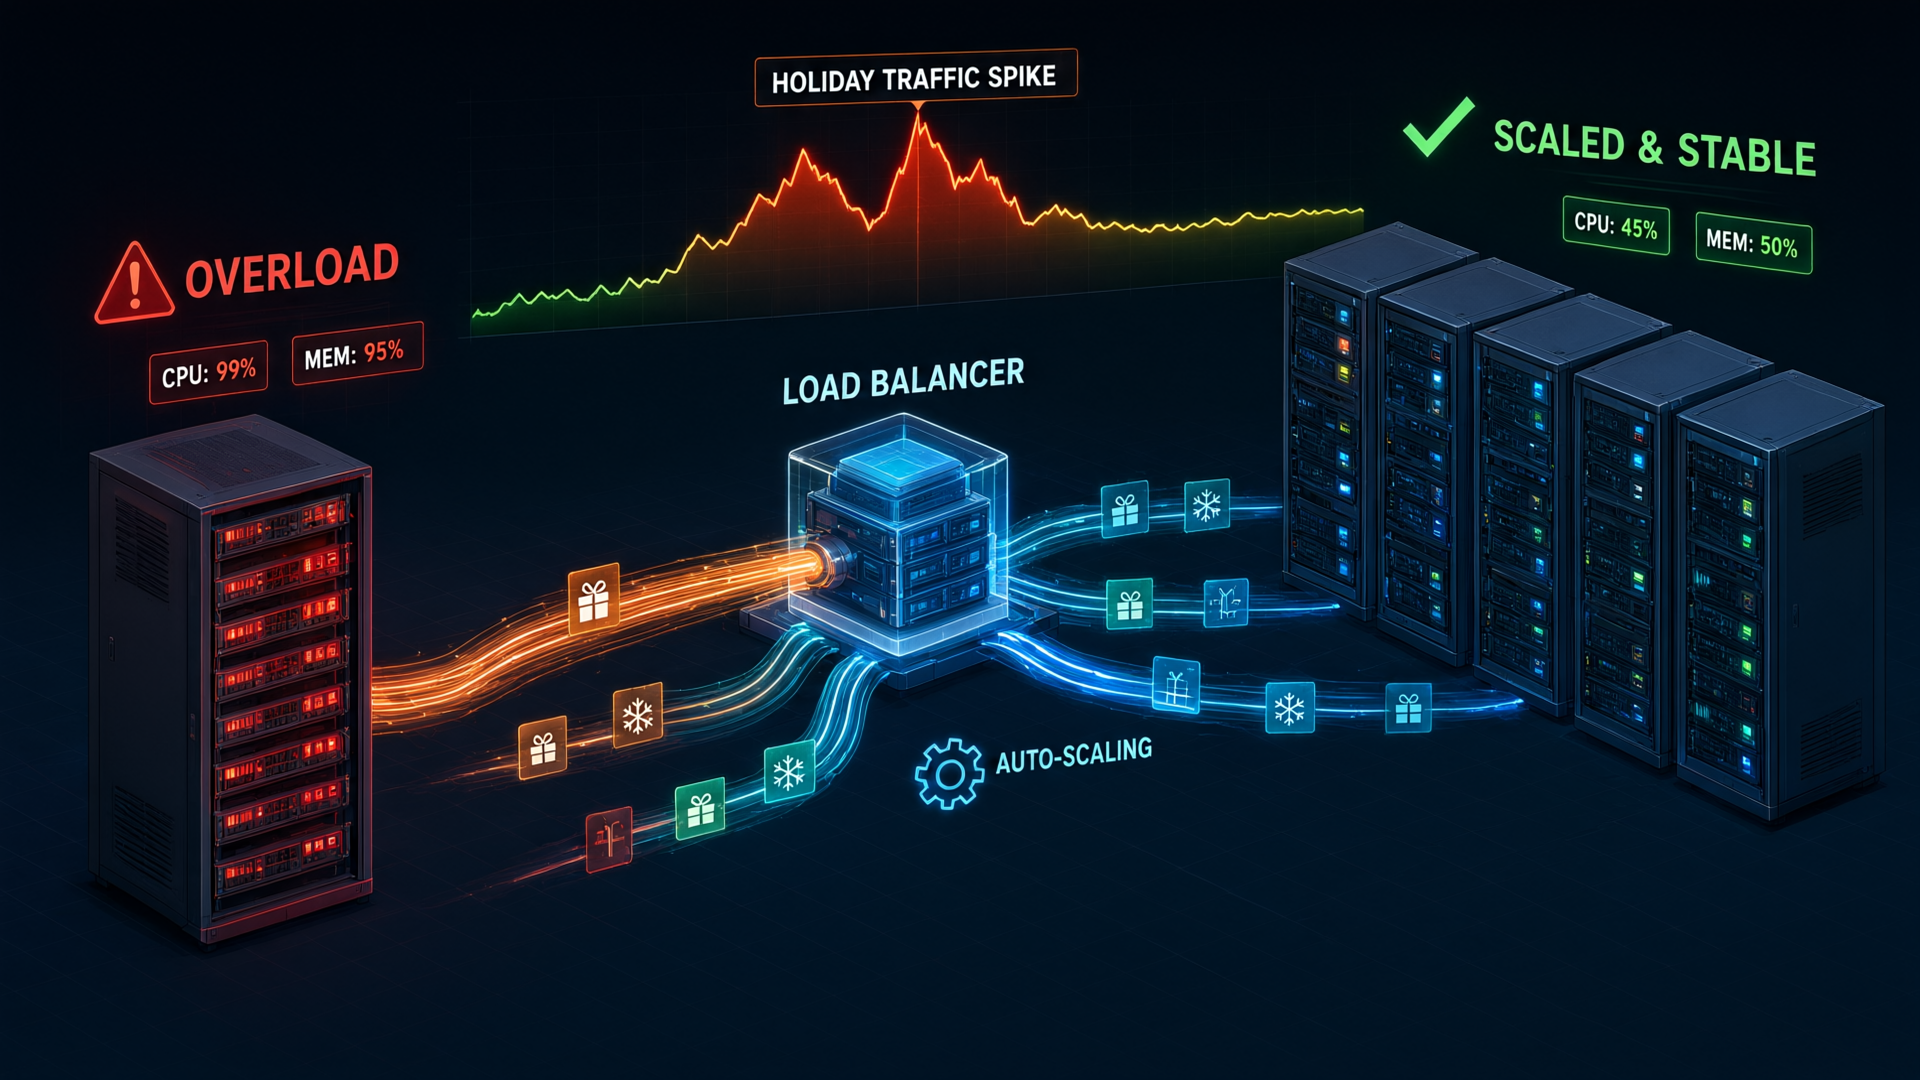
Se você trabalha com e-commerce ou qualquer sistema com pico sazonal de fim de ano, setembro é o mês em que o planejamento de capacidade começa de verdade — não em novembro, quando já é tarde para mudar arquitetura. Se o seu sistema tem IA em algum ponto do fluxo (busca semântica, recomendação, atendimento automatizado, geração de descrição de produto), esse componente tem características de risco que a infraestrutura tradicional não tem, e vale revisar cedo.
1. O custo por request escala com o volume, não é fixo
Diferente de um servidor web, onde o custo marginal de mais uma requisição é quase zero até bater num limite de capacidade, cada chamada a um modelo de IA tem custo direto em tokens. Um pico de 10x no tráfego normal não é só uma questão de escalar réplicas — é 10x o custo de inferência, no mesmo período. Vale simular esse número agora, com o volume esperado de Black Friday, e não descobrir na fatura de dezembro.
2. Latência sob carga não é a mesma latência do dia normal
Provedores de modelo têm limites de rate e, sob alta demanda coletiva (todo mundo do mercado escalando ao mesmo tempo em novembro), a latência de resposta pode degradar mesmo com a sua infraestrutura própria saudável. Se o seu sistema depende de resposta rápida do modelo para uma etapa crítica do checkout ou da busca, um plano de fallback — resposta em cache, versão simplificada sem IA, degradação graciosa — precisa estar pronto antes do pico, não sendo escrito às pressas durante o incidente.
3. Rate limit do provedor é um teto real, não uma sugestão
Verifique agora, não em novembro, qual é o rate limit contratado com o provedor de modelo e se ele comporta o pico projetado. Se não comportar, o processo de aumentar limite ou negociar um tier diferente leva tempo — geralmente mais do que as poucas semanas que restam entre setembro e o pico real. Esse é o item mais fácil de esquecer porque não aparece em nenhum dashboard até o momento em que o sistema começa a devolver erro de limite excedido, no pior momento possível.
4. Cache agressivo para os casos mais repetidos
Em pico de tráfego sazonal, uma fração enorme das interações se repete — as mesmas perguntas sobre os mesmos produtos em alta. Cachear respostas para os casos mais frequentes (com expiração adequada, para não servir informação desatualizada de estoque ou preço) reduz custo e latência exatamente onde o volume é maior. Esse ajuste, feito agora, tem retorno desproporcional em novembro.
5. Monitoramento precisa estar calibrado para o volume novo, não para o normal
Alertas configurados para o tráfego de um dia comum vão ou disparar sem parar durante o pico (alert fatigue, ninguém mais presta atenção) ou não capturar degradação real porque os limiares estão calibrados errado. Vale revisar os thresholds de alerta pensando explicitamente no volume esperado de pico, não no volume médio do ano.
O checklist resumido
Simule o custo de inferência no volume de pico. Tenha um plano de fallback para quando a latência do provedor degradar. Confirme o rate limit contratado contra a projeção de volume. Implemente cache agressivo nos casos mais repetidos. Recalibre os alertas de monitoramento para o volume esperado, não o volume normal.
Nenhum desses cinco pontos é complexo isoladamente. O problema é sempre o mesmo: são itens fáceis de adiar até que não sobra mais tempo para resolvê-los direito. Setembro ainda é tempo suficiente. Novembro não vai ser.